Beam 權重上線:不拼每個 token 更便宜,拼一件事少燒多少 token
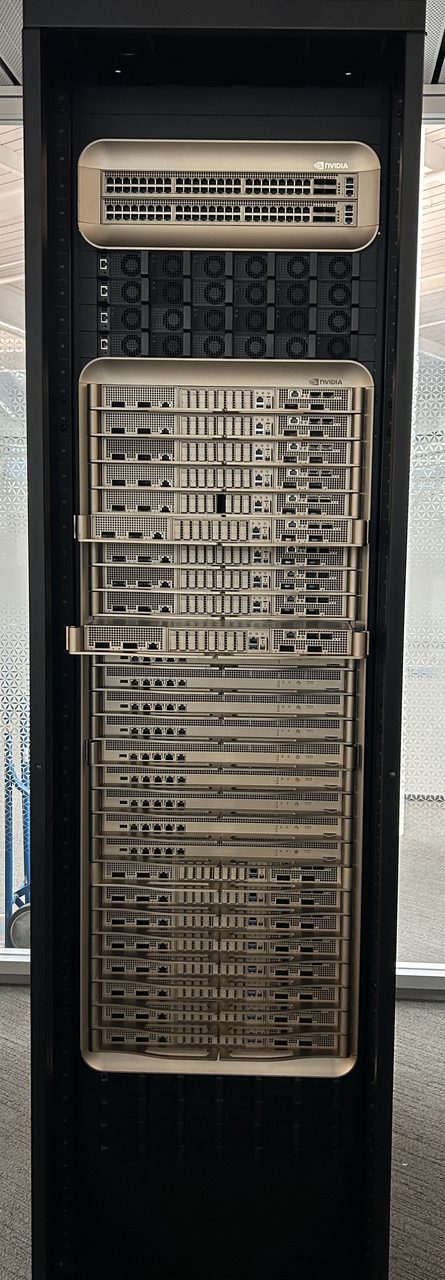
圖片:NVIDIA, CC BY-SA 4.0, via Wikimedia Commons · via Wikimedia Commons
Beam 權重上線:不拼每個 token 更便宜,拼一件事少燒多少 token
501B 權重上線,每次只叫醒 23B
10 月 16 日,Reflection AI 把首個開放權重模型 Beam 的權重放上 Hugging Face,標註 Apache 2.0 許可。它是一個稀疏混合專家(MoE)模型:總參數 5010 億,每生成一個 token 只激活 230 億,約 22 個參數裏 1 個在幹活。上下文窗口 100 萬 token,提供 BF16、FP8、NVFP4 三檔權重,外加 DFlash2 草稿模型、分詞器和一套 Rust 寫的 Mirror 工具鏈。10 月 5 日首發時它還在紅隊測試階段、只能走候補名單;這次是真正可下載。
賣效率不賣跑分,自報省三到四倍算力
Reflection 的說法是,Beam 在高級推理測試上達到"與 GLM-5.2 相當"的水平,而推理算力只用後者的三分之一到四分之一。公司還主動承認了短板:在原始能力上,像 Kimi K3 這樣的前沿開源模型仍然領先,"Beam 的優勢在推理階段的效率"。換句話說,它賣的不是跑分第一,而是"同樣一件事,少花算力"。
算力賬單:6144 塊卡預訓練,10500 塊卡做強化學習
據 eWeek,預訓練喫掉 23.8 萬億 token 數據,跑在 6144 塊英偉達 GB300 上,耗時約四周。隨後是一輪同樣四周的強化學習,用 10500 塊 GB300,約 13 億次沙盒評估,估算花費 2000 萬到 4000 萬美元。"省三到四倍算力"是 Reflection 自己的估算口徑:用激活參數乘平均生成 token 數,不含提示詞讀取等開銷——VentureBeat 明確指出這是估算而非實測。
不降價,改讓模型少繞彎來降本
美國企業已在用更便宜的中國開源模型,Reflection 沒加入"每百萬 token 多少錢"的競價,而是把賬算到"完成一件事"上:強化學習里加了可控的長度懲罰,逼模型少寫無用的思考步驟;據官方披露,模型還自發學會了瀏覽類技能,儘管訓練數據裏沒有這類任務。
跑分咬得住,命令行任務仍落後
官方表裏,Beam 在 SWE-bench Verified 拿 80.9、GPQA Diamond 拿 90.5,但 Terminal-Bench 2.1 的 80.1 低於 GLM-5.2 的 81.0、Kimi K3 的 88.3 和 DeepSeek V4.1 Flash 的 90.6。這些數字全是廠商自評,Epoch AI 的獨立評測尚未出爐。
瞄準企業自建與主權客戶
Beam 主要瞄準企業自建和主權 AI 客戶:把模型放進自家機房和合規邊界,不租 API。發佈時已有 40 多家生態夥伴,AWS 把它放進 SageMaker JumpStart,vLLM 首日支持並宣稱解碼延遲降低 2.71 倍。代價是硬件門檻:自建必須把全部參數裝進顯存,FP8 權重約 501GB。而對英偉達來說,誰跑贏都得買它的卡。
單價優勢還在中國模型手裏
對照價格:DeepSeek V4 Pro 每百萬輸入 0.66 美元、輸出 1.98 美元,Beam 則至今沒公佈 token 價目——"更便宜"目前還沒有標價支撐,真正的檢驗是記錄各自完成同一任務花多少 token。
公司賬本:47 億美元融資,70 億美元算力合同
Reflection 2024 年由兩位前 Google DeepMind 研究員在布魯克林創立,累計融資 47 億美元(英偉達出資 8 億),4 月一輪投前估值 250 億美元。算力端,它與 SpaceX Colossus 2 簽下每月 1.5 億美元、到 2029 年最高 63 億美元的租約,加上 Nebius 超 10 億美元的合同,合計鎖定 70 億美元以上算力。
獨立評測尚未出爐,收購傳聞尚早
拿到早期訪問的 Artificial Analysis 說,Beam 是同智能水平裏最省 token 的開源模型之一。10 月 10 日,英國《金融時報》報道英偉達正與 Reflection 商談加深投資甚至收購,可能採取"人才+技術授權"形式避開冗長審查。Laskin 在 CNBC 上說,這個模型讓他們進入了中國開源前沿的"射程之內"。對打算上生產線的團隊,多家媒體的建議是一致的:先把每個任務實際消耗的 token 記下來,再決定換不換。
本文來源
- VentureBeat
- TechCrunch
- SiliconANGLE
- DataCamp
- eWeek