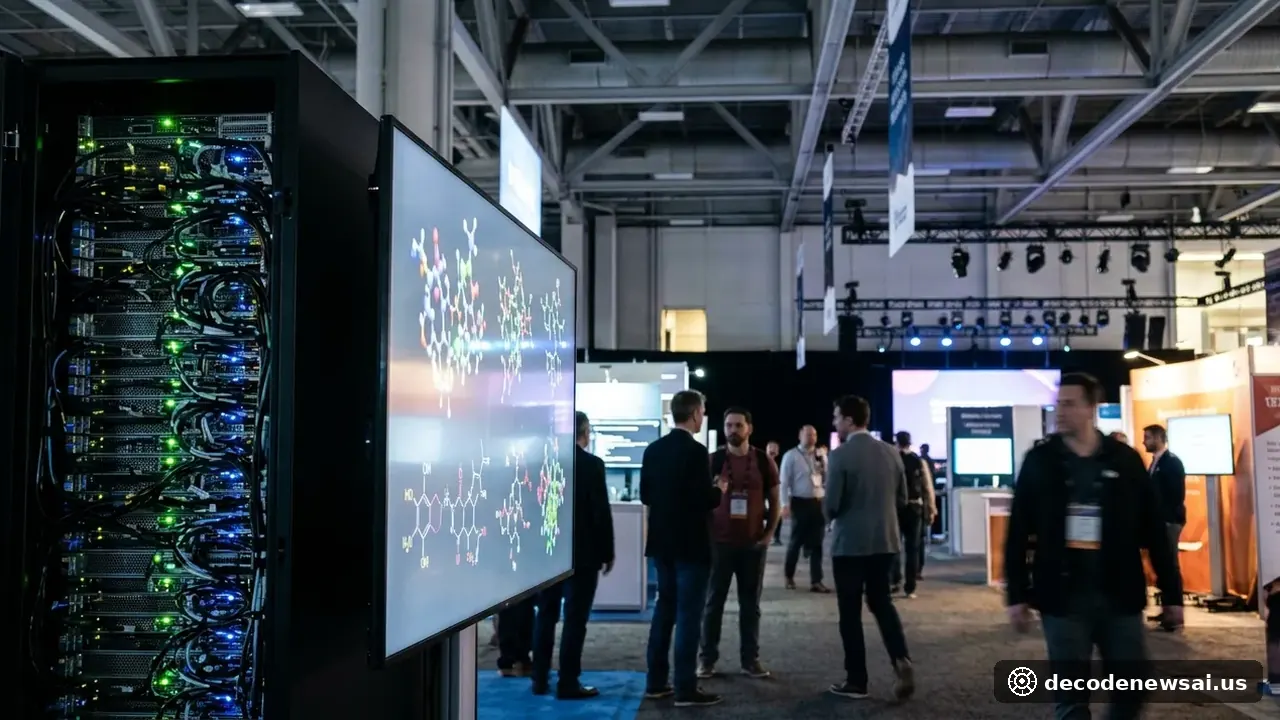
【美國芝加哥,2026年11月16日電】英偉達11月16日在芝加哥舉行2026年超級計算大會。會上發佈了科研智能體平臺。平臺整合開源多模態模型與近五萬道化學推理題目,用於協助研究機構加速藥物發現與材料研發。
開源化學推理數據集助力分子特性預測
平臺核心是名爲Nemotron 3.5 Super VL的開源多模態模型。配套推出名爲LitmusBench v0.2的化學推理數據集。數據集包含近50000道推理題目,基於分子特性和藥物研發實驗數據。這些題目用於訓練和評估人工智能模型,預測分子溶解度以及人體代謝方式。
藥物代謝預測實驗中,經過監督微調後模型準確率提升了12%。結合強化學習後訓練又進一步提升了17%。英偉達超大規模與高性能計算副總裁伊恩·巴克表示,這套平臺爲研究人員提供了開源模型、科學數據和後訓練方案。目標是構建專用智能體,能夠推理科學問題,並藉助加速計算工具將想法轉化爲發現。
多家生科企業與國家實驗室已展開實測部署
生命科學公司Lila Sciences利用實驗室反饋對模型進行後訓練。在製造量子點材料的準確率上達到61%,超過同類模型GPT-6 Astra的54%。同時推理成本降低了10至20倍。
另一家生物技術企業Terray Therapeutics利用該模型從科學圖表中提取化學反應條件。在RxnScribe基準測試中恢復了約76%的標註反應。此外,瑞典皇家理工學院利用單臺DGX Spark系統在一夜之間修復了81%的故障分子動力學測試案例。美國能源部阿貢國家實驗室和日本理化學研究所也已接入該模型。
目前,該模型與數據集已在Hugging Face平臺向公衆開放下載。